我们要做一个这样的接口:业务方提交工单和候选组,服务直接返回 network、device、software 的分数与选择结果。业务方不用处理 token,也不用从模型生成的文字里解析答案。
Jev 的类型化决策接口提供了这种使用方式。本文借鉴它的接口思路,用基础语言模型和 vLLM 设计一个自建服务,重点是请求如何变成候选分数,以及单 token、多 token 两条路径如何统一起来。
1 先确定 API 接收什么、返回什么
先实现 POST /evaluate,请求中包含一份 state 和若干带 ID 的问题。下面是我们自己的接口设计:
{
  "state": "笔记本浏览器联网正常,但 VPN 连接失败。重装客户端无效,日志多次出现网卡驱动重置。",
  "questions": {
    "route": {
      "type": "choice",
      "instructions": "这张工单应先转给哪个组?",
      "options": {
        "network": "链路、DNS、VPN 网关",
        "device": "本机网卡、驱动、固件",
        "software": "VPN 客户端软件"
      }
    }
  }
}
route 是调用方指定的问题 ID,服务在响应中原样保留。一次请求可以有多个问题,但每个问题先独立完成候选准备和打分。
期望的响应如下,数值仅用于说明格式:
{
  "answers": {
    "route": {
      "type": "choice",
      "status": "ok",
      "choice": "device",
      "candidate_weights": {
        "network": 0.0470834,
        "device": 0.9456961,
        "software": 0.0072205
      }
    }
  }
}
candidate_weights 表示在给定候选中的相对权重,不是经过验证的业务正确率。如何计算这些权重,第 6 节会说明。
三个问题类型可以共用同一个打分后端,只在候选准备和结果组装时有所区别:
| 类型 | 业务方提供什么 | 内部候选 | 最后返回什么 |
|---|---|---|---|
| Choice | options,标签与含义的映射 | 标签对应的答案文本 | 最大权重的标签与完整分布 |
| Score | levels,从低到高的级别描述 | 各个级别的答案文本 | 级别编号的加权平均与完整分布 |
| Noul | 是非问题的 instructions | Yes、No | yes 的候选权重 |
第一版只接受文本 state。Choice 至少有两个非空候选,Score 至少有两个有序级别;Noul 的候选由服务生成。先把这个小接口做正确,再扩展输入类型。
2 整个请求如何经过系统

图 1 中最重要的分支发生在 tokenizer 编码之后。不能看到 Urgent 是一个英文单词,就认为它只占一个 token;也不能只对裸标签分词,而忽略它接在 prompt 后的实际形式。
第一版采用两条简单规则:
- —所有候选都只有一个 token:共用 prompt 最后位置的分布,查询所有候选的 logprob。
- —任一候选包含多个 token:整组使用序列打分,包括同组中只有一个 token 的候选。
如果快速路径返回的分数不完整,也让整组回退到序列打分。这样只维护一套补救逻辑,不必在第一版里混合不同来源的分数。
服务可以拆成四个模块:
api.py         校验请求,保留问题 ID,组装响应
compiler.py    构造 prompt,生成候选文本,验证 token 边界
scorer.py      选择单 token / 序列打分路径,适配模型后端
results.py     归一化分数,生成 Choice / Score / Noul,应用拒答策略
下面按这条处理链路展开。代码展示模块之间的契约,省略 HTTP 路由和模型加载;vLLM 的版本差异由模型适配层处理。
3 先把语义问题编译成可计分的 token
3.1 Prompt 必须包含候选的含义
语言模型给出的分数描述“这段输入后接某段文本有多可能”。因此要先让 prompt 明确表达分类任务:
工单:笔记本浏览器联网正常,但 VPN 连接失败。
重装客户端无效,日志多次出现网卡驱动重置。

这张工单应先转给哪个组?只填写一个标签。
network:链路、DNS、VPN 网关
device:本机网卡、驱动、固件
software:VPN 客户端软件

Answer:
options 的描述用于帮助模型理解标签;真正计分的是接在 Answer: 后的答案文本,例如 " device"。业务标签与计分文本分开保存:返回给用户的是 device,内部计分可以包含空格或其他统一格式。
基础模型可以使用这种续写模板;聊天模型需要适配其 chat template。确定模板后,要固定模型、tokenizer 和模板的版本,使分数变化可追溯。
3.2 重要的坑:`Yes` 和 ` Yes` 不是同一个查询
假设我们问“这张工单需要人工介入吗”,prompt 停在 Answer:。下面两个续写对应不同的完整文本:
| 候选文本 | 拼接后的文本 |
|---|---|
"Yes" | "Answer:Yes" |
" Yes" | "Answer: Yes" |
对于某些 tokenizer,两种写法还会对应不同的 token ID 或 token 数量。即使它们在人看来都表示 yes,模型对这两段续写的概率也可能差很多。
如果我们约定答案前有空格,却查询裸 Yes 的 token,取到的就不是目标答案的分数。 此时低 logprob 可能只是格式不匹配,不能解释为模型倾向于 no。
在这个示例中,我们统一约定:prompt 以不带尾随空格的 Answer: 结束,候选文本统一带一个前导空格。
# 外部 key 用于响应;value 才是模型实际评分的文本。
answer_texts = {
    "yes": " Yes",
    "no": " No",
}
Choice 也采用同一约定,例如 " device"。不要只给 yes 加空格,也不要在准备好计分文本后随手调用 strip()。这套约定仍须通过下一步的边界检查,并非任意 tokenizer 都会把它编码成单 token。
3.3 重要的坑:分别编码再拼接,可能改变答案边界
不能直接假设:
encode(prompt + answer) == encode(prompt) + encode(answer)分词可能跨过字符串边界合并字符。例如左边结尾是 Y,右边是 es,整体编码可能把 Yes 合成一个 token。如果还按原来的 prompt 长度切候选,就会切错。
所以 compiler 应对完整拼接文本编码,再确认 prompt 的 token 前缀没有改变:
def compile_candidates(tokenizer, prompt, answer_texts):
    prefix = tokenizer.encode(prompt, add_special_tokens=False)
    if not prefix:
        raise ValueError("empty_prompt")

    candidates = {}
    for key, text in answer_texts.items():
        whole = tokenizer.encode(prompt + text, add_special_tokens=False)
        if whole[:len(prefix)] != prefix:
            raise ValueError("unstable_answer_boundary")
        suffix = whole[len(prefix):]
        if not suffix:
            raise ValueError("empty_candidate")
        candidates[key] = suffix

    encoded = [tuple(ids) for ids in candidates.values()]
    if len(set(encoded)) != len(encoded):
        raise ValueError("duplicate_candidate_encoding")
return prefix, candidates返回结果中,prefix 是所有候选共享的 prompt tokens,candidates[key] 才是该答案的实际后缀。这时才能检查每个后缀的长度,选择后续路径。
边界检查失败,应修改统一模板后重新验证,或者返回明确的编码错误;不能按猜测的偏移继续算。这里省略了特殊 token 的加入方式,真实后端应与模型的 BOS、chat template 等约定保持一致。
还可以把复杂标签映射成经验证的短答案码,如 A/B/C,并在 prompt 中解释映射。这能增加走单 token 路径的机会,但仍需检查实际编码,并测试交换答案码或顺序是否会影响结果。
4 单 token 路径:一次查齐所有候选
把 prompt 送入模型做一次 forward,最后一个位置的 logits 可以转换为“下一个 token”的 logprob。Logprob 就是概率的自然对数:越接近 0,概率越大。它与概率的排名一致,而且适合后面的多 token 累加。
如果 compiler 返回的每个候选都恰好只有一个 token,就只需要查询这一行中的多个 token ID:
# 后端契约:返回 {token_id: 原始 logprob}。
# 参数是经过 compiler 验证的 IDs,不是硬编码的裸单词 IDs。
token_ids = [ids[0] for ids in candidates.values()]
by_token = backend.next_logprobs(prompt_ids, token_ids)
scores = {
    key: by_token[ids[0]]
    for key, ids in candidates.items()
}
三个候选共享同一次模型计算,这就是 Fast Path。固定 prompt 时,增加几个查分目标通常不必重做模型 forward;但增加候选描述会使 prompt 变长,仍有输入成本。
假设得到以下示例分数:
| 候选 | logprob |
|---|---|
| network | -4.5401 |
| device | -1.5401 |
| software | -6.4151 |
此时 device 领先。先保留整组原始分数,第 6 节再统一转换为 API 结果。
分数不在 Top-N 中,不能填成 0
有些后端只返回概率最高的 N 个 token。候选缺席意味着接口没返回它的值,不是概率为 0。若 logprob 填 0,反而相当于填入概率 1,会把这个候选错误地排到最前面。
优先让后端按指定 token ID 返回分数。vLLM 的 SamplingParams 有 logprob_token_ids 等能力,但所部署版本和 HTTP 接口未必全部支持,应由适配层检查。
若无法完整取得分数,第一版让整组走下一节的序列打分。两条路径都应返回原始模型分布的 logprob。vLLM 的 logprobs_mode 区分原始值与采样处理后的值,适配层应明确使用 raw_logprobs,避免把 logits 或经过 temperature、top-p、logit bias 等处理的分数拿来比较。
5 多 token 路径:给已知答案逐位置计分
假设候选 " Urgent" 在当前模板下编码为两个 token,记作 u₁、u₂。在下面的公式中,x 表示 prompt,y 表示整个候选。它的完整分数需要两项:
- 1.prompt 后出现
u₁的 logprob; - 2.已经接上
u₁后,出现u₂的 logprob。
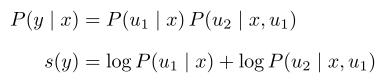
例如,两项概率分别是 0.4 和 0.25,整个候选的概率就是 0.1,总 logprob 约为 −2.303。只查询第一个 token,就会漏掉第二步。
对更长的候选,也是累计各位置的 logprob。这个总分称为 conditional log-likelihood。无论候选是一个 token 还是多个 token,scorer 都返回同一含义的分数。
5.1 已知候选可以一次送入模型
这里不需要等模型生成 u₁:答案已经给定,我们直接把它作为输入前缀。这种操作称为 teacher forcing,在本服务里只用于计分,不更新模型参数。
将 prompt + u₁ 一次送入因果语言模型:prompt 最后位置的输出预测 u₁,u₁ 所在位置的输出预测 u₂。因果 mask 阻止每个位置读取未来 token,因此可以一次 forward 取得两项分数。

下面的代码展示单个候选的核心计算。前提是 prompt、候选均非空,compiler 已验证边界,当前样本没有 padding:
import torch

def score_sequence(model, prompt_ids, candidate_ids):
    full_ids = prompt_ids + candidate_ids
    inputs = torch.tensor([full_ids[:-1]], device=model.device)
    model.eval()
    with torch.inference_mode():
        logits = model(inputs).logits[0].float()
        logprobs = logits.log_softmax(dim=-1)

    p, m = len(prompt_ids), len(candidate_ids)
    positions = torch.arange(p - 1, p + m - 1, device=logprobs.device)
    targets = torch.tensor(candidate_ids, device=logprobs.device)
    return logprobs[positions, targets].sum().item()
这里最容易错的是 p−1。如图 2,prompt 有三个 token 时,输出位置 2 才是在预测候选的第一个 token;从位置 3 开始会错开一格。full_ids[:-1] 则移除了最后一个目标 token,因为输入到它的前一个 token,已经足够取得它的预测分数。
服务后端提供 sequence_logprobs(prompt_ids, candidates),返回 {候选 key: 总 logprob}。它可以先逐候选调用上述逻辑建立正确性基线,再做 batch。
使用 vLLM 的 prompt_logprobs 时,应提交完整的 prompt_ids + candidate_ids,让每个候选 token 都成为已知输入,再读取候选区间的分数;这里不能照搬上面直接读取 logits 时的 [:-1]。vLLM 返回的 prompt logprob 已按被评分的输入 token 对齐,适配层应按目标 token ID 取值,避免再次错移。批处理还要排除 padding 的位置。
只要一个候选需要多个 token,第一版就让整组走这个后端。 单 token 候选也能按相同公式计算,不需要另外设计一套比较规则。
5.2 还要明确两个计分约定
候选在哪里结束。 当前分数表示模型接下来输出候选 token 序列的概率,没有要求到此结束。如果 " New" 的 token 序列也是 " New York" 的前缀,两个事件就有重叠,归一化权重不能解释成互斥完整答案的概率。若协议要求完整答案,应为所有候选加入并计分统一的结束标记,并检查编码后的序列不再互为前缀。结束标记也计入 token 数,可能使快速路径变成序列路径。
是否按长度归一化。 第一版统一使用总 logprob,不对某些候选单独除以长度。平均 logprob 会改变排名规则,可以作为后续实验,但必须整组使用,并明确记录。短答案码能减少标签长度差异,也需要任务评测。
6 把两条路径接到同一个 API handler
到这里,compiler 输出 prompt_ids 和 candidates,两条打分路径最终都应输出 {key: 总 logprob}。handler 串联候选编译、打分与结果组装;路径选择封装在 score_candidates 中:
import math

class ScoringError(Exception):
    pass

def complete(scores, keys):
    return (
        set(scores) == set(keys)
        and all(math.isfinite(v) for v in scores.values())
    )

def score_candidates(backend, prompt_ids, candidates):
    all_single = all(len(ids) == 1 for ids in candidates.values())

    if all_single and backend.supports_next_logprobs:
        token_ids = [ids[0] for ids in candidates.values()]
        by_token = backend.next_logprobs(prompt_ids, token_ids)
        scores = {
            key: by_token[ids[0]]
            for key, ids in candidates.items()
            if ids[0] in by_token
        }
        if complete(scores, candidates):
            return scores

    # 多 token、快速接口不支持或快速取分不完整:整组序列打分。
    scores = backend.sequence_logprobs(prompt_ids, candidates)
    if not complete(scores, candidates):
        raise ScoringError("incomplete_candidate_scores")
    return scores

def normalize(scores):
    peak = max(scores.values())
    weights = {key: math.exp(value - peak) for key, value in scores.items()}
    total = sum(weights.values())
    return {key: value / total for key, value in weights.items()}

def evaluate(request, backend, tokenizer, policy):
    validate_request(request)
    answers = {}
    for question_id, question in request["questions"].items():
        # prepare_question 按类型生成 prompt、候选文本及级别映射。
        prepared = prepare_question(request["state"], question)
        prompt_ids, candidates = compile_candidates(
            tokenizer, prepared.prompt, prepared.answer_texts
        )
        scores = score_candidates(backend, prompt_ids, candidates)
        weights = normalize(scores)
        answers[question_id] = format_answer(prepared, weights, scores, policy)
return {"answers": answers}这是编排代码,backend 的两个方法以及 prepare_question、format_answer 是需要实现的适配点。验证通过的请求保证候选非空且至少有两个,compiler 再保证编码不重复。上面的 complete 把非有限值作为计分异常处理;不要用随意填充的值凑齐结果。
6.1 先归一化,再按问题类型返回
normalize 对整组总 logprob 做 softmax。减去最大值用于数值稳定;除以总和后,各个候选的权重相加等于 1。
把第 4 节的示例分数代入,就得到开头响应中的 4.71%、94.57%、0.72%。即使所有候选都不合适,也会有一个权重最高的候选,所以不能把 94.57% 直接当作业务正确率。
format_answer 按类型执行以下规则:
| 类型 | 组装规则 |
|---|---|
| Choice | choice = max(weights, key=weights.get),同时返回完整 candidate_weights |
| Score | 按 levels 顺序分配 0, 1, 2, …,计算 sum(i * weight_i),返回级别说明与分布 |
| Noul | 返回 weights["yes"],表示 yes 相对 no 的权重 |
例如,Score 三档权重为 [0.02, 0.23, 0.75],加权结果为 0×0.02 + 1×0.23 + 2×0.75 = 1.73。这里默认相邻级别等距,1.73 是该量表上的加权位置,与候选的总 logprob 含义不同。若业务级别只有顺序、没有等距含义,应返回级别及其分布,避免对平均值作过度解释。
6.2 拒答和后端错误分开处理
policy 使用当前任务验证过的阈值决定是否接受结果。可以观察最大候选权重和第一、二名的分数差,但阈值要用标注数据确定。绝对 logprob 还受标签长度、词频与格式影响,不适合作为跨任务通用阈值。
若证据不足,format_answer 返回 status: "abstain"、原因与候选分布,将类型对应的决定字段设为 null;调用方据此补充信息或转人工。调用方只有在 status == "ok" 时才使用决定字段。
推理超时、后端不可用、候选分数缺失则属于服务错误,不能伪装成 abstain。第一版可采用整次请求失败的语义,由 HTTP 层返回明确错误;如果以后允许部分问题成功,再增加逐问题的错误结构。
7 接入 vLLM 后,先验证正确性,再减少重复计算
首先固定模型、输入 token 和取分设置,用同一个单 token 候选分别跑两条打分路径,检查分数是否在合理数值误差内一致。再用多 token 候选比较逐步续算与整段 teacher forcing,确认每个位置的 logprob 在合理数值误差内一致。
重点覆盖四种失败情况:Yes 与 Yes 的格式差异、拼接导致 token 边界改变、快速路径漏返候选,以及混合单 token / 多 token 的候选集合。这几项会直接影响 API 返回值,比先做复杂缓存更重要。
正确性通过后,多候选性能的主要问题是重复处理 prompt。假设输入有 4500 个 token,多个候选只有一两个 token,逐候选完整计算会反复处理相同的长输入。

Prefill 是处理已有输入、建立 attention 的 Key/Value 缓存的过程。多个候选若共享这份 KV,就能减少公共 prompt 的重复计算;候选后缀仍需各自续算。
可以先 batch 提高并行度,再验证 prefix caching 是否复用了公共 KV。Batch 不自动等于共享 prefill;所用 vLLM 版本中,prompt_logprobs 与 prefix caching 的组合也需要验证。参考 vLLM 前缀缓存文档,对比固定负载下的缓存命中、实际计算量和端到端延迟。
一次 API 请求有多个问题时也一样:共享 state 不代表问题 prompt 相同。可以把稳定的 state 放在前、问题放在后,为复用公共前缀创造条件,但是否命中由后端决定。
单 token 路径用于加速,多 token 序列路径提供通用计分基线。先确保两条路径对同一候选给出一致的分数,再优化延迟。
参考资料
- —TypeSafe System One 与 Primitives:类型化决策接口的参考。
- —vLLM SamplingParams:取分参数;部署时固定版本并检查接口支持范围。
- —lm-evaluation-harness Model Guide:conditional log-likelihood 与预测位置对齐。
- —vLLM Automatic Prefix Caching:前缀复用。