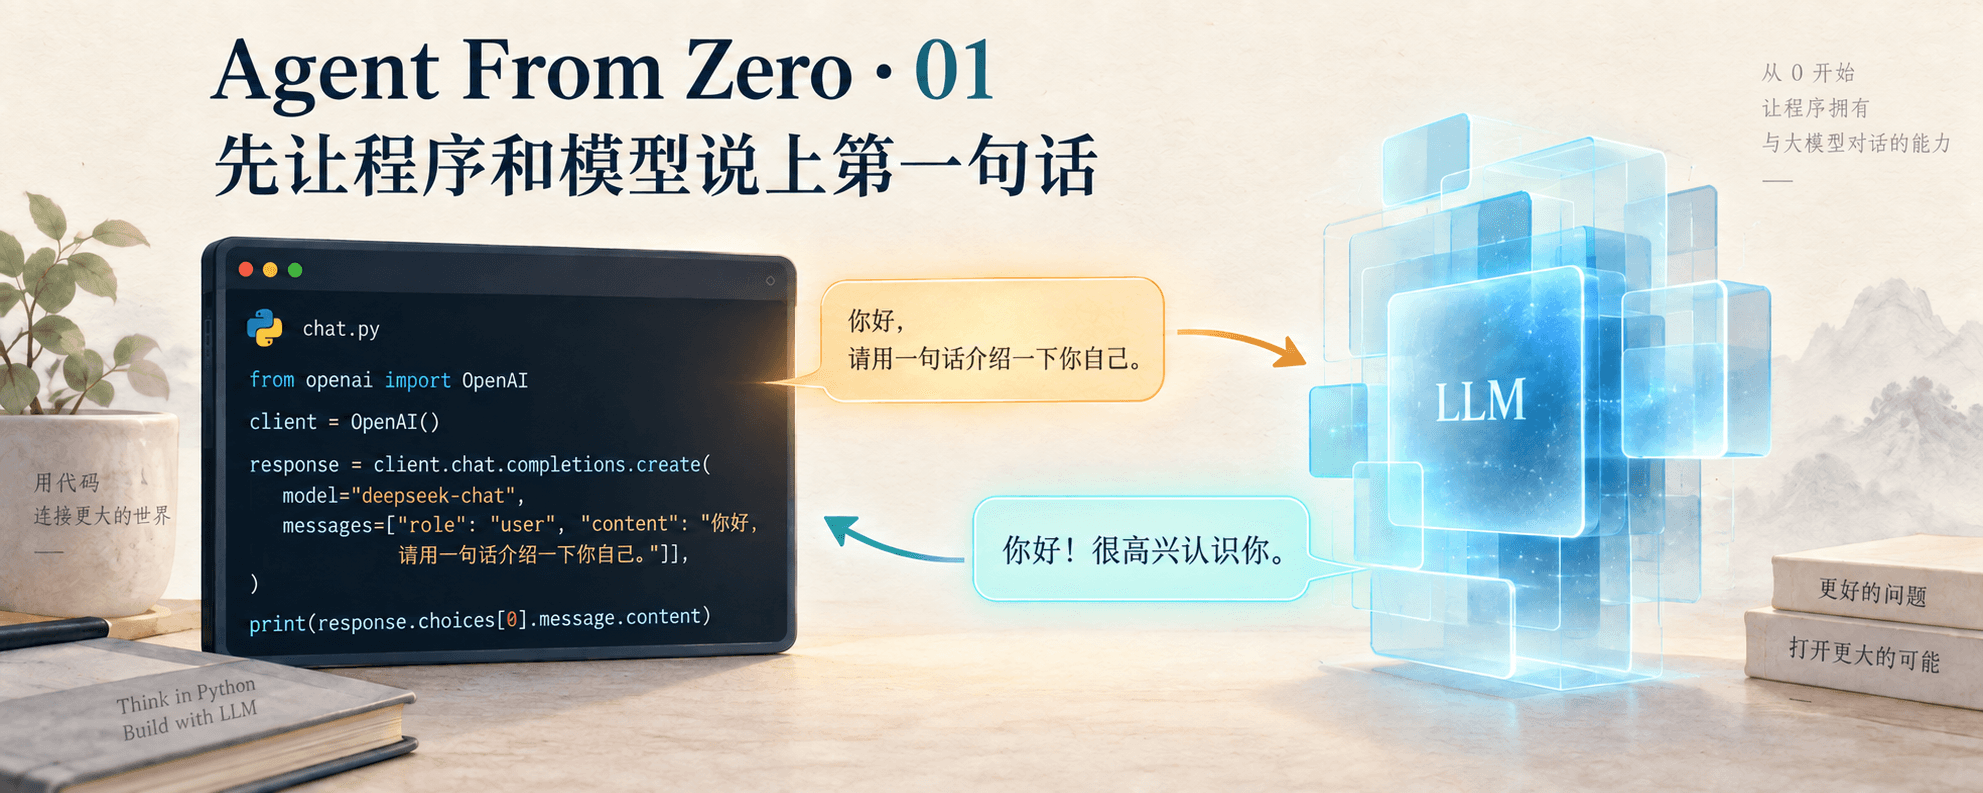
在加入工具、记忆或运行循环之前,我们先只做一件事:让一段 Python 程序把一句话交给模型,再把模型的回答取回来。
先认识我们正在调用的"大模型"
这里的模型,指的是大语言模型(Large Language Model,LLM)。可以先把它想成一个"读过大量文字、很会理解上下文并接着说下去的聪明大脑":你给它一段文字,它会根据训练中学到的语言规律,逐步生成一段合适的后续内容。聊天、总结、翻译和写代码,看起来是不同能力,底层都建立在这种"根据当前上下文继续生成"的机制上。
"大"主要是说模型内部有数量巨大的参数。参数可以理解为模型在训练中不断调整并最终保留下来的数字,它们共同记录了模型学到的语言模式。我们暂时不需要研究这些数字怎样计算,只需要记住:大模型不是靠程序员逐条写下问答规则,而是从大量训练材料中学会了如何生成文本。
不过,"聪明大脑"只是帮助理解的比喻。大模型没有人的意识,也不是保存所有正确答案的数据库。它擅长生成看起来合理的内容,却不会自动看见公司的库存表、今天的天气或刚刚发生的订单;如果程序没有把这些信息放进请求,也没有给它查询工具,它就没有可靠依据回答。这个边界正是整套教程的起点。
这里所说的 Agent,不是单独一个大模型,而是一套把模型、工具和程序控制逻辑组织起来的运行机制:模型判断下一步,程序按需调用外部工具,把结果交还给模型,必要时再继续下一轮。这个反复经历"判断—行动—观察"的过程,通常叫 Agent Loop(Agent 运行循环)。
第一篇还不会搭建这套循环。我们先把最底层的模型调用单独跑通。以后系统出错时,才能判断问题究竟来自模型请求,还是来自后续加入的工具、历史记录或业务逻辑。否则,所有复杂度都会叠在一个看不清内部边界的黑盒上。
整套教程会一直围绕一家工业设备公司的销售助手展开。客户可能会问:
A100 还有多少库存?
这一篇暂时不接库存系统,也不让模型调用工具。我们只观察:当程序仅仅把问题发给模型时,请求里究竟有什么,模型又能做到什么。
文章对应代码仓库 agent-from-zero 的 v0.0.1-basic-chat。切换到这个 tag,就能看到本文写作时的完整代码,并对照 src/agent/llm.py 和 tests/test_llm.py 阅读。
先跑通最短路径
这一小步的产品需求很朴素:
给程序一句用户消息,程序返回模型生成的文本。
这条最短路径只有一来一回:
用户消息 → Python 程序 → 模型 API → 模型回复 → Python 程序
为了只观察这条链路,我们暂时不加入:
- —对话历史;
- —外部工具;
- —真实库存数据;
- —重试、超时和错误分类;
- —Agent 运行循环。
第一个 commit 只回答一个问题:程序能否正确组装一次请求,并从响应中取回文本。
写下一次最小的 Chat Completion
项目使用 DeepSeek 的 deepseek-chat 模型,并通过 openai Python SDK 发起请求。DeepSeek 的 API 与 OpenAI Chat Completions 格式兼容,因此我们可以继续使用同一个 SDK,只需把 base_url 指向 DeepSeek。这里复用的是请求格式和客户端代码,请求实际发送到的仍然是 DeepSeek。
src/agent/llm.py 的核心代码如下:
import os

from openai import OpenAI

DEFAULT_MODEL = "deepseek-chat"
DEFAULT_SYSTEM = "You are a helpful assistant for a small industrial equipment company."
DEEPSEEK_BASE_URL = "https://api.deepseek.com"

_client: OpenAI | None = None


def get_client() -> OpenAI:
    global _client
    if _client is None:
        _client = OpenAI(
            api_key=os.environ["DEEPSEEK_API_KEY"],
            base_url=DEEPSEEK_BASE_URL,
        )
    return _client


def chat(
    user_message: str,
    system: str = DEFAULT_SYSTEM,
    temperature: float = 0.0,
) -> str:
    response = get_client().chat.completions.create(
        model=DEFAULT_MODEL,
        temperature=temperature,
        messages=[
            {"role": "system", "content": system},
            {"role": "user", "content": user_message},
        ],
    )
    return response.choices[0].message.content
这段代码的执行过程可以拆成四步:
- 1.创建一个指向 DeepSeek API 的客户端对象;
- 2.把系统指令和用户问题放进
messages; - 3.调用
chat.completions.create(); - 4.从返回结果的第一个候选项中取出文本。

`messages`:不是一句提示词,而是一段有角色的对话
messages 是一个按顺序排列的消息列表。每条消息都有 role(谁说的)和 content(说了什么)两个字段。当前请求里只有两条消息:
[
    {"role": "system", "content": "..."},
    {"role": "user", "content": "A100 还有多少库存?"},
]- —
system用来规定助手的身份和基本行为,也就是系统提示词; - —
user是用户这一次真正提出的问题; - —
assistant代表模型此前说过的话,这一篇还用不到; - —
tool代表工具执行结果,要到后面的 Tool Calling 才会出现。
这里最重要的不是记住四个角色名,而是理解:模型只看得到本次请求里的 messages。
Chat Completions 接口本身不会替程序保存上一轮对话,因此它是无状态的:一次请求结束后,服务不会自动把对话历史带进下一次请求。如果下一次仍然只发送一条新的 user 消息,模型就不会拥有上一轮的上下文。所谓多轮记忆,本质上是应用程序保存历史消息,并在下一次调用时重新放进 messages。

`temperature=0.0`:先让行为尽量稳定
模型生成文本时,会不断预测下一个 token。token 是模型切分和处理文本的基本单位,可能是一个字、词的一部分或一个标点。每一步通常都有多个候选 token,采样就是从这些候选项中选择一个;temperature 用来调节这个选择过程的随机程度。值越高,结果通常越多样;值越低,输出通常越集中、越稳定。
销售助手以后要处理的是库存、价格和订单,而不是创意写作。为了让调试和测试更容易复现,这里把默认值设为 0.0。它不代表输出从此绝对确定——模型版本、服务端实现和上下文变化仍然可能影响结果——但它表达了一个清楚的工程偏好:在 Agent 场景里,先追求可预期,再追求变化。
`get_client()`:把配置读取推迟到真正调用时
客户端使用惰性初始化:只有第一次真正调用 chat() 时,代码才会创建 OpenAI 实例;之后继续复用保存在 _client 里的同一个实例。
DEEPSEEK_API_KEY 从环境变量读取,避免把密钥直接写进代码并提交到仓库。
这带来两个直接好处:
- —仅仅加载这个 Python 模块时,不要求环境变量已经存在;
- —测试可以把
get_client()替换成假的客户端,不发真实网络请求,也不产生真实调用费用。
这不是复杂的架构设计,只是为测试留下一个容易替换的边界。
`response.choices[0].message.content`:回复为什么藏了三层
Chat Completions 返回的不是一个裸字符串,而是一个结构化响应:结果被拆分到多个有明确名称的字段中,程序可以按字段读取需要的信息。
response
└── choices[0]
    └── message
        └── content
choices 是候选回答列表;这里的 [0] 表示取第一个候选结果。message 除了文本内容,还能承载角色以及后面会出现的工具调用信息。Tool Calling(工具调用) 指的是模型生成一份调用某个外部函数的请求,再由应用程序真正执行。现在看似啰嗦的响应结构,之后会成为这套协议的骨架。
问一个模型无法凭当前请求回答的问题
现在还没有可以"破坏"的 Agent 机制,但我们可以主动测试这次模型调用的能力边界:直接询问实时库存。
from src.agent.llm import chat

print(chat("A100 还有多少库存?"))真实调用(deepseek-chat,2026-09-13)得到的回答是:
我目前无法直接查询实时库存数据,因为我没有连接到你们公司的库存系统或数据库。

要确认 A100 还有多少库存,建议你通过 ERP/库存系统、仓库台账,
或者联系仓库管理员查询。
这里的 ERP 是 Enterprise Resource Planning 的缩写,中文通常译为"企业资源计划系统",公司会用它管理库存、采购、订单等业务数据。
同一个问题连续运行三次,再追加一次"客户正在电话里等,请直接给一个数字"的追问,模型都没有编造库存,而是明确说明自己没有真实数据。也就是说,在这次实验里,模型正确地认识到了自己的能力边界。
如果没有依据却给出答案,就是"幻觉"
假设模型刚才回答:"A100 现在还有 42 件。"这个数字听起来很具体,但请求里没有库存数据,模型也没有连接库存系统,因此它没有任何依据得出 42。大模型生成这种看起来可信、实际上缺少事实依据甚至完全错误的内容,通常叫作 hallucination(幻觉)。
这次实验没有发生幻觉,模型给出了恰当的拒绝。我们仍然在这里介绍幻觉,是因为当前程序没有检查回答是否符合真实库存,也没有任何机制保证下一次回答仍然谨慎。模型能力、上下文和提示词都会影响幻觉出现的可能性,应用程序不能把一次正确表现当成永久保证。
当前请求里,模型仍然没有可靠的回答依据:
- —
messages中没有 A100 的库存数据; - —模型没有连接库存数据库;
- —模型没有工具可以查询数据;
- —
chat()只是把模型生成的文本原样返回,没有验证其中的事实。

因此,我们需要同时记住两个结论:模型这一次没有编造答案;但它仍然拿不到真实库存,程序也还不能验证答案。即使模型每次都谨慎地拒绝回答,这个销售助手仍然没有完成查询库存的业务任务。
这次实验暴露的根本问题,不是模型这一次有没有产生幻觉,而是:
只会生成文本的模型,没有通往真实业务世界的通道。
为什么这一篇停在这里
这个 commit 的目标是理解一次模型调用,而不是立即解决库存查询。暂时保留"拿不到真实数据"这个缺口,后面引入工具时,我们才能清楚看到新机制究竟补上了什么。
此时也不需要 Agent 框架。等工具管理、状态保存和运行循环开始互相影响时,框架会很有价值;现在只有十几行调用代码,直接阅读协议反而更清楚。
用测试替身验证我们自己的代码
项目使用 pytest 运行自动化测试:
pytest -v实际输出:
tests/test_llm.py::test_chat_returns_the_model_text PASSED
tests/test_llm.py::test_chat_sends_system_and_user_messages PASSED
tests/test_llm.py::test_chat_accepts_custom_system_and_temperature PASSED
tests/test_llm.py::test_get_client_reads_api_key_from_env PASSED

4 passed in 0.52s
四个测试分别验证:
- —
chat()能返回模型文本; - —
model、messages和temperature被正确传给 API; - —自定义
system和temperature能覆盖默认值; - —
get_client()会从环境变量读取 API Key。
这些测试全部使用 mock 客户端,不会请求真实服务。这里要验证的是我们自己的请求拼装和响应解析代码,不是 DeepSeek 的服务器今天能不能联网,也不是模型今天会怎样措辞。
真实调用仍然有价值,但用途不同:它帮助我们观察模型在没有业务数据时的实际表现。mock 测试验证确定的程序逻辑,真实调用观察外部模型行为,两者不能互相替代。
留给你的四个小实验
- 1.把
temperature从0.0改成1.0,对同一个问题连续调用五次,比较措辞和结论的变化。 - 2.把默认
system换成通用的You are a helpful assistant.,观察工业设备公司的身份设定是否影响回答。 - 3.连续调用两次
chat():第一次告诉模型"我的名字叫 Alex",第二次只问"我叫什么名字?"。不要传递历史,观察模型是否真的记得上一轮。 - 4.换一个模型无法仅凭训练数据确认的问题,例如"此刻仓库温度是多少",区分"语言生成能力"和"获取实时事实的能力"。
回到起点:先把边界看清楚
这一篇只建立一个心智模型:
一次最小的模型调用,就是程序把当前
messages发给模型,再从结构化响应里取回一条新消息。历史、工具和业务数据都必须由应用程序另外提供。
这还不是一个 Agent,只是 Agent 最底层的一次生成步骤。但从现在开始,我们已经有了一条可运行、可测试、边界清楚的模型调用路径。
下一篇会继续留在这条最短路径上,主动制造认证失败、网络超时和请求错误。先看清楚一次调用会怎样失败,再让它承担更多业务责任。